 LEADERMINE
AI 검색 노출을 두고 오가는 말은 대개 "나오더라" 와 "안 나오더라" 둘입니다. 둘 다 관측이지만 다음 달에 다시 쓸 수 없는 관측입니다. 언제, 어느 채널에서, 어떤 질문으로 확인했는지가 남지 않기 때문입니다. 측정이 되려면 자가 있어야 하고, 그 자는 다음 달에도 같은 눈금이어야 합니다.
이 글은 리더마인이 쓰는 자를 그대로 펼쳐 놓은 문서입니다. 5영역 17항목, 배점 A 30 / B 25 / C 20 / D 15 / E 10, 항목마다 양호, 보완, 결함 셋 중 하나로 판정합니다. 중요한 것은 그 아래, 항목을 무엇으로 어떻게 재고 근거를 어떻게 남기며 언제 다시 재는지입니다.
1. 먼저 실측: 자사 AI 랩 사이트, 잠정 70점
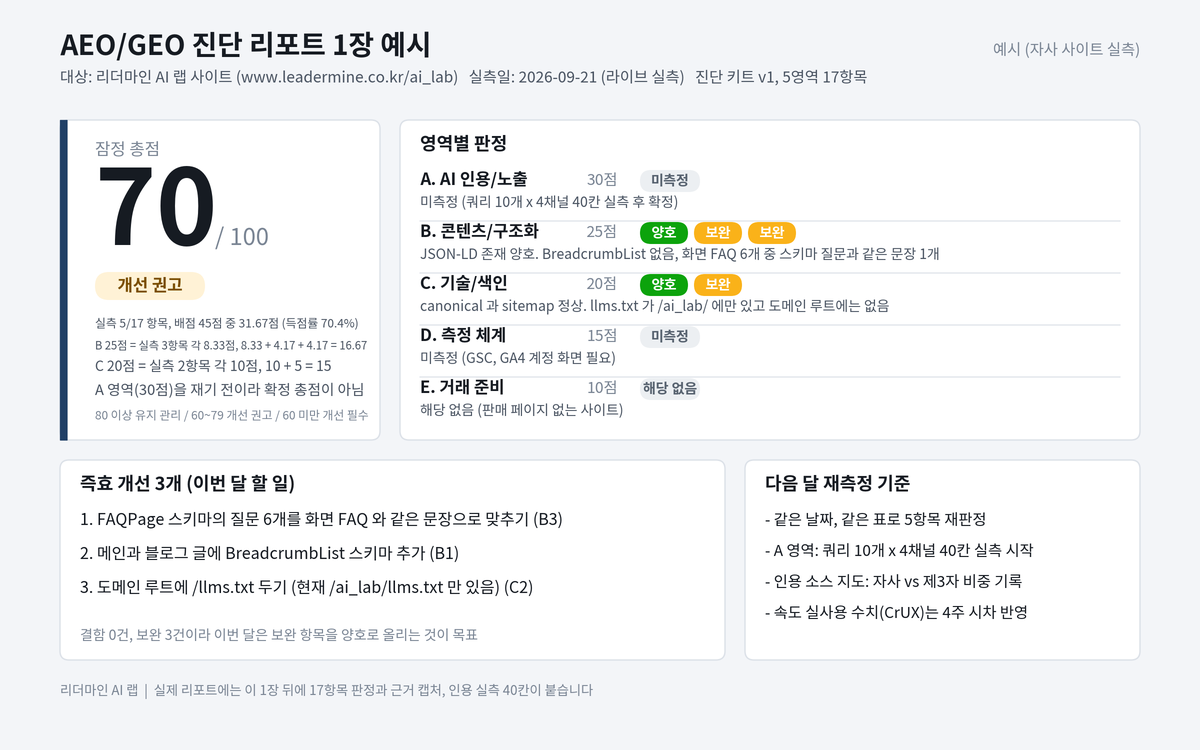
2026년 9월 21일, 브라우저로 서비스 중인 www.leadermine.co.kr/ai_lab 를 열어 B 와 C 영역 5항목을 라이브로 쟀습니다. A 는 캡처 날짜 없는 숫자를 넣지 않았고, D 는 계정 화면이 필요해 뺐으며, E 는 해당 없음입니다.
| 항목 | 실측값 (2026-09-21 라이브) | 판정 |
|---|---|---|
| B1 스키마 존재 | 메인 JSON-LD @graph 에 Organization, WebPage, FAQPage 세 노드. Product 는 해당 없음 | 양호 |
| B1 브레드크럼 | @graph 에 BreadcrumbList 노드가 없음 | 보완 |
| B3 FAQ 정합 | 화면 FAQ 6개와 스키마 질문 6개 중 문장이 같은 것은 1개, 나머지 5개는 다름 | 보완 |
| C1 정규 주소 | canonical 이 https://www.leadermine.co.kr/ai_lab/ 로 정상 선언 | 양호 |
| C2 파일 3종 | 루트 robots.txt 200 전체 허용, Sitemap 2줄. /ai_lab/sitemap.xml 200, URL 12개 중 lastmod 10개. /ai_lab/llms.txt 200(2,769바이트). 루트 /llms.txt 404 | 보완 |
B1 은 원래 한 항목이지만, 여기서는 확인한 단위대로 둘로 나눠 적었습니다.
잠정 총점 70점의 계산
미측정 영역(A 30, D 15)과 해당 없음 영역(E 10)을 분모에서 빼고, 남은 영역 배점을 실측 항목끼리 균등하게 나눕니다. B 25점을 3항목에 나누면 항목당 8.33점이라 8.33 + 4.17 + 4.17 = 16.67점, C 20점을 2항목에 나누면 항목당 10점이라 10 + 5 = 15점. 실측 배점 45점 중 31.67점, 득점률 70.4%, 잠정 총점 70점입니다. A 가 빠져 확정 총점이 아니므로 잠정 총점에는 언제나 "실측 5/17" 을 붙입니다.
보완 3건이 그대로 즉효 개선 3개
- FAQPage 스키마의 질문 6개를 화면 FAQ 와 같은 문장으로 맞추기 (B3)
- BreadcrumbList 스키마 추가 (B1)
- 도메인 루트에 llms.txt 두기 (C2, 현재는 /ai_lab/llms.txt 만 있음)
결함 0건, 보완 3건이라 이 셋이 그대로 이번 달 할 일입니다. 세 가지 모두 이 글을 올리는 배포에 함께 반영했습니다. 이 페이지의 JSON-LD 에 4단계 BreadcrumbList 가 들어 있고, 아래 FAQ 절의 문장과 FAQPage 스키마의 문장이 글자 단위로 같은 것이 그 결과입니다. FAQ 불일치는 화면 문구를 고치면서 스키마를 같이 고치지 않아 생긴 문제로, 이번에 처음 잡혔습니다.
2. 채점 구조: 왜 A 에 30점인가
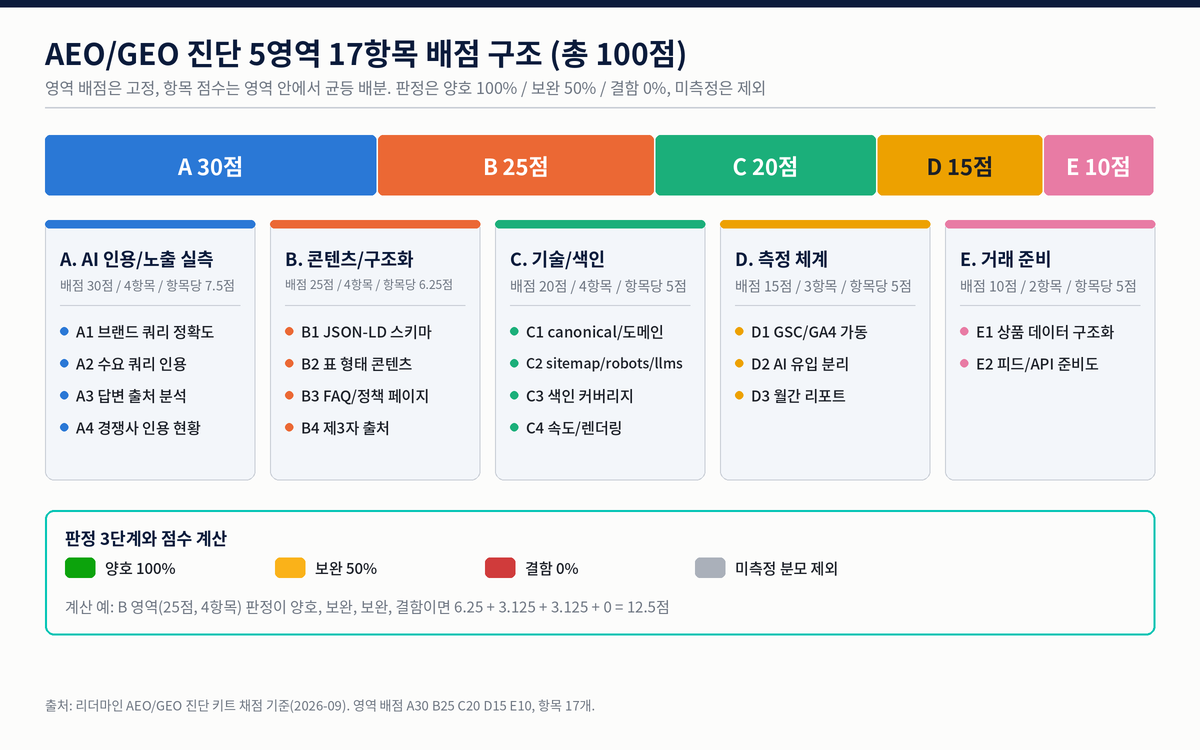
영역 배점은 고정, 항목 점수는 영역 안에서 균등 배분입니다. A 에 가장 크게 둔 이유는 나머지 네 영역이 "인용될 준비" 이고 A 만 "실제로 인용되는가" 이기 때문입니다.
| 영역 (배점) | 항목 | 무엇을 보나 |
|---|---|---|
| A. AI 인용/노출 실측 (30점) | 4개, 7.5점 | AI 채널이 브랜드와 수요 쿼리에 우리 몰을 인용하는지, 출처는 누구인지 |
| B. 콘텐츠/구조화 (25점) | 4개, 6.25점 | AI 가 읽고 인용할 형태로 정보가 정리되어 있는지 |
| C. 기술/색인 (20점) | 4개, 5점 | 크롤러가 막힘없이 읽고 색인하는지, 속도와 렌더링은 충분한지 |
| D. 측정 체계 (15점) | 3개, 5점 | 개선 뒤 변화를 잴 도구가 켜져 있는지 |
| E. 거래 준비 (10점) | 2개, 5점 | AI 에이전트가 상품을 읽고 추천하게 데이터가 준비됐는지 |
판매 페이지가 없는 사이트는 E 를 해당 없음으로 두고 분모에서 뺍니다. 카페24 자사몰은 E 가 살아 있어 상품 데이터 정합이 곧 추천의 입력값입니다.
3. 17항목: 무엇을, 무엇으로 재는가
셋째 칸은 "무엇을 본다" 가 아니라 "무엇으로 열어서 무엇을 확인한다" 로 적었습니다.
| 번호 | 항목 | 측정 절차 |
|---|---|---|
| A1 | 브랜드 쿼리 정확도 | 브랜드명을 4채널에 질의. 오답과 옛 정보, 타사 정보 혼입 표시 |
| A2 | 수요 쿼리 인용 여부 | 수요 쿼리 7개의 답변과 출처 목록에 자사 도메인이 든 비율 |
| A3 | 답변 출처 분석 | 인용된 답변의 출처 URL 을 도메인 단위로 자사와 제3자로 분류 |
| A4 | 경쟁사 인용 현황 | 인용된 경쟁 도메인과 그 페이지 형태(표, FAQ, 기사) |
| B1 | JSON-LD 스키마 | ld+json 파싱 후 @graph 노드 타입, FAQPage 문장과 화면 대조, position 연속성 |
| B2 | 표 형태 콘텐츠 | 기준과 비교를 표로 제시한 페이지 유무. 이미지가 아닌 텍스트인지 |
| B3 | FAQ/정책 페이지 | 배송과 교환, 멤버십이 질문형 구조인지, 스키마와 화면 문장이 같은지 |
| B4 | 제3자 출처 | 언론과 블로그에 실린 자사 정보의 최신성과 사실 일치 |
| C1 | canonical/도메인 통일 | canonical 의 www 포함 여부, 비www 와 http 의 최종 도착 주소, 중복 색인 |
| C2 | sitemap/robots/llms.txt | 직접 열어 응답 코드, 허용 정책, URL 과 lastmod 개수, 바이트 수 |
| C3 | 색인 커버리지 | 서치콘솔 색인 보고서 실측. site: 검색은 참고 수치로만 |
| C4 | 속도/렌더링 | PSI 랩 수치와 CrUX 실사용 수치를 나눠 기록. JS 없이 본문이 보이는지 |
| D1 | GSC/GA4 가동 | 속성 연결, 권한, 최근 수집일 |
| D2 | AI 유입 분리 측정 | chatgpt.com 등 AI 도메인 referral 세그먼트가 GA4 에 있는지 |
| D3 | 월간 리포트 체계 | 누가, 언제, 무엇을 보는지 문서로 정해져 있는지 |
| E1 | 상품 데이터 구조화 | 상품명과 옵션, 재고 표기의 일관성. 피드로 뽑을 수준인지 |
| E2 | 피드/API 준비도 | AI 채널용 카탈로그 피드 또는 조회 API 존재 여부 |
B1: JSON-LD 를 검증하는 절차
소스에서 application/ld+json 블록을 전부 꺼내 파싱합니다. 하나라도 파싱되지 않으면 그 페이지는 그 시점에 구조화 데이터가 없는 페이지입니다. @graph 를 펼쳐 노드 @type 목록을 만들고 Organization, WebSite, Product, FAQPage, BreadcrumbList 유무를 봅니다. 여기까지가 존재 판정입니다. 정합 판정은 FAQPage 의 질문과 답을 화면 문자열과 글자 단위로 대조하고, BreadcrumbList 의 position 이 1부터 이어지는지와 각 item 주소가 200 으로 열리는지를 봅니다. 리치 결과 테스트와 검증기는 문법만 보고 본문 일치는 보지 않으므로, 정합은 따로 대조해야 합니다.
C2: robots, sitemap, llms.txt 를 실측하는 절차
세 파일은 추측하지 않고 주소로 직접 엽니다. /robots.txt 에서는 응답 코드, User-agent 별 Allow 와 Disallow, Sitemap 줄의 개수와 대상, GPTBot 같은 AI 크롤러를 막는 줄이 있는지를 적습니다. Sitemap 이 가리키는 주소에서는 응답 코드, URL 개수, lastmod 가 붙은 URL 개수를 셉니다. lastmod 가 비면 무엇이 최근에 바뀌었는지 크롤러가 알 수 없습니다. /llms.txt 는 응답 코드와 바이트 수를 적습니다. 저희는 /ai_lab/llms.txt 가 200 에 2,769바이트, 루트 /llms.txt 는 404 였습니다. 하위 경로에만 있으면 그 밖을 읽는 크롤러에게는 없는 것과 같습니다.
C1: canonical 과 도메인 통일
canonical 값이 www 를 포함한 정규 주소인지, 비www 와 http 주소가 거기로 모이는지를 봅니다. 값이 비www 이면 두 주소가 서로 다른 페이지로 쌓입니다. 이 글의 canonical 과 og:url 을 www 로 맞춘 이유입니다.
4. 판정 규칙과 총점 산식
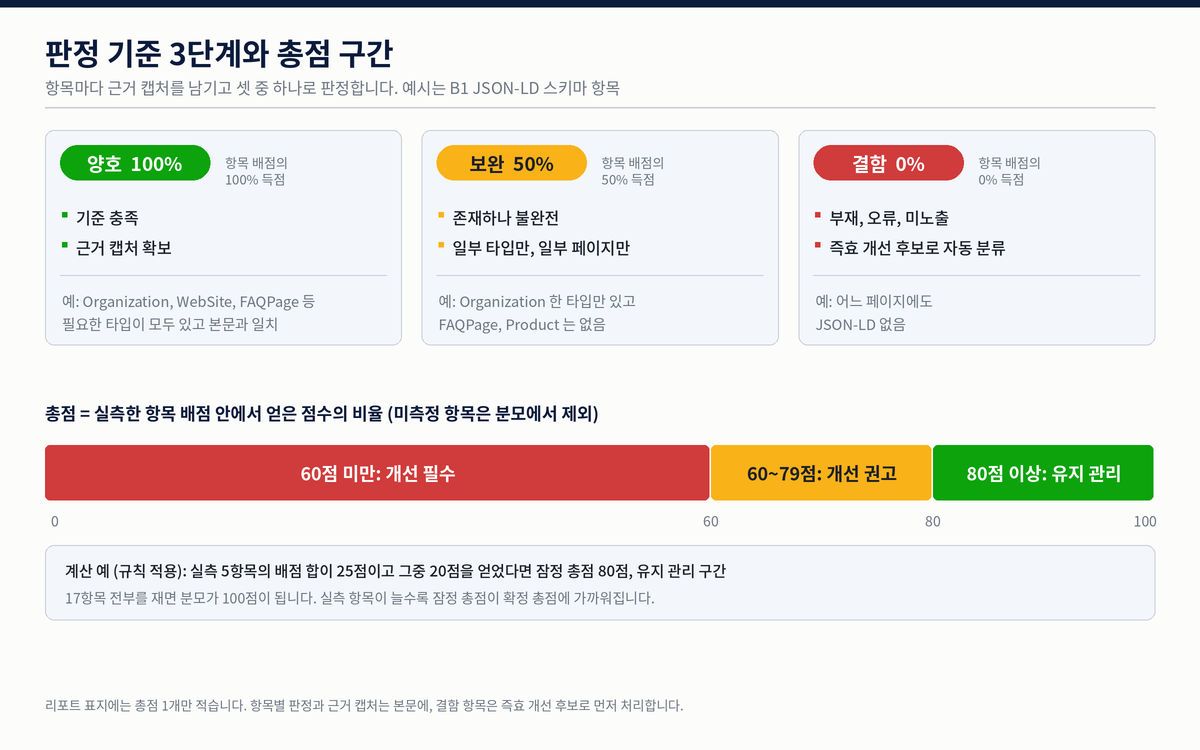
판정에는 근거 캡처가 반드시 붙습니다. 캡처가 없으면 양호로 적지 않습니다. 이 한 줄이 채점표를 의견에서 기록으로 바꿉니다.
| 판정 | 득점 | 기준 |
|---|---|---|
| 양호 | 배점의 100% | 기준 충족에 근거 캡처까지 확보 |
| 보완 | 배점의 50% | 존재하나 불완전. 스키마 일부 타입만, 색인 커버리지 70~90% 등 |
| 결함 | 배점의 0% | 부재, 오류, 미노출. 즉효 개선 후보로 분류 |
| 미측정 | 분모에서 제외 | 권한이나 자료가 없어 못 잰 항목. 영역 배점을 실측 항목끼리 나눔 |
총점은 실측 항목의 배점 합 안에서 얻은 점수의 비율입니다. 17항목을 전부 재면 분모가 100점이 되고 그때부터 확정 총점입니다. B 영역 4항목이 양호, 보완, 보완, 결함이면 항목당 6.25점이므로 6.25 + 3.125 + 3.125 + 0 = 12.5점입니다.
| 총점 구간 | 뜻 | 다음 행동 |
|---|---|---|
| 80점 이상 | 유지 관리 | 매월 같은 쿼리셋으로 재측정, 결함 0 유지 |
| 60~79점 | 개선 권고 | 결함 항목부터 즉효 개선, 다음 달 재측정 |
| 60점 미만 | 개선 필수 | 즉효 개선 3개 먼저, 1개월 뒤 재측정 후 로드맵 |
5. A 영역: 쿼리 10개 x 채널 4개, 40칸을 채우는 절차
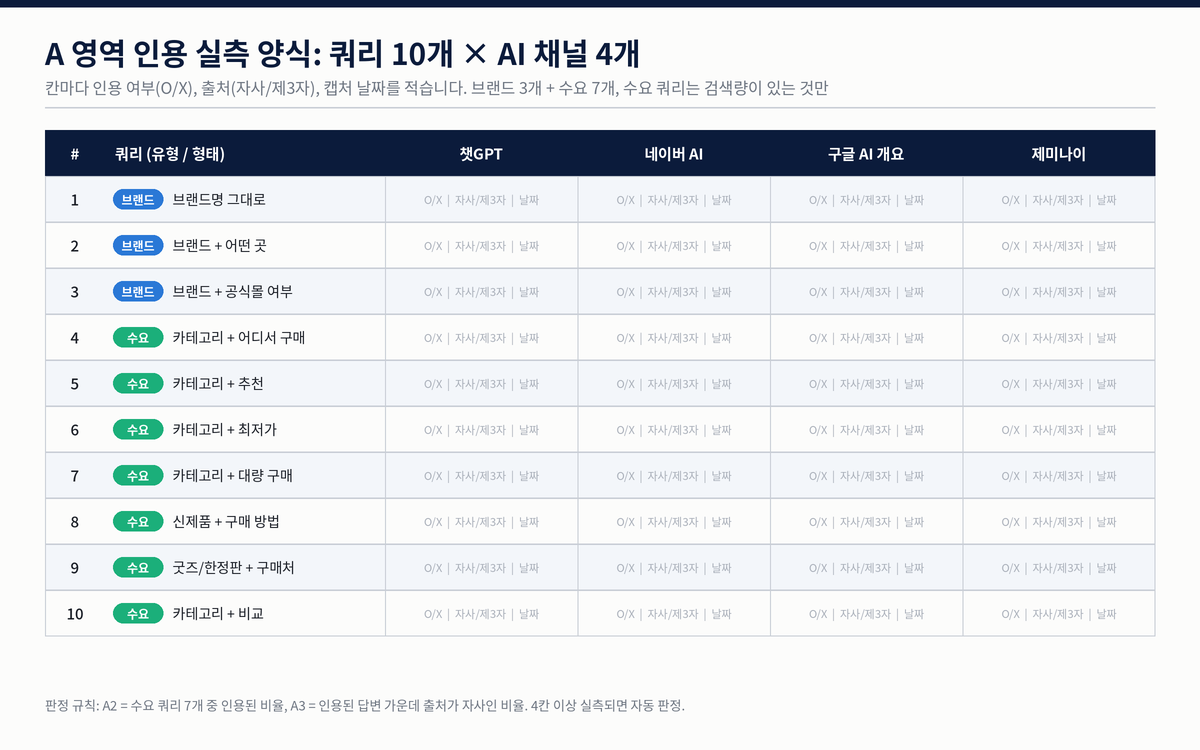
A 영역은 이 글에 숫자를 넣지 않았습니다. 캡처 날짜가 없는 숫자는 비교 재료가 되지 않기 때문입니다. 대신 40칸을 채우는 규칙을 적습니다.
쿼리셋 10개를 정하는 규칙
브랜드 3개와 수요 7개입니다. 브랜드 쿼리는 브랜드명 그대로, 브랜드명과 어떤 곳인지, 브랜드명과 공식몰 여부. 수요 쿼리는 카테고리와 구매처, 추천, 최저가, 대량 구매, 한정판 구매처, 비교처럼 구매 의도가 담긴 문장입니다. 규칙은 하나, 네이버 키워드도구에서 월 검색량이 확인되는 쿼리만 씁니다. 검색량이 있어야 인용이 방문으로 이어집니다.
4채널 질의 조건을 맞추는 규칙
챗GPT, 구글 AI 개요, 제미나이, 네이버 AI 브리핑 네 곳에 같은 문장을 그대로 넣습니다. 개인화가 섞이지 않게 로그인하지 않은 창이나 새 대화에서 묻고, 쿼리마다 대화를 새로 엽니다. 한 회차의 40칸은 가능하면 같은 날 안에 끝냅니다. 며칠에 걸쳐 재면 한 회차에 서로 다른 시점이 섞입니다.
인용 셀 하나에 적는 네 가지
| 기록 항목 | 값 | 쓰는 이유 |
|---|---|---|
| 인용 여부 | O / X | A2 판정. 수요 쿼리 7개 중 인용된 비율 |
| 출처 | 자사 / 제3자 | A3 판정. 출처가 자사여야 직접 고칠 수 있음 |
| 캡처 날짜 | YYYY-MM-DD | 다음 달 같은 날짜대에 재측정해 비교 |
| 경쟁 인용 | 몰 이름, 페이지 형태 | A4 판정. 인용 페이지 형태를 개선안에 반영 |
넷이 다 들어가야 셀이 완성입니다. 출처를 비우면 A3 를 판정할 수 없고, 캡처 날짜가 없으면 다음 달 비교에서 그 칸을 버립니다. A2 와 A3 는 40칸 중 4칸 이상 채워지면 자동 판정합니다. 이 표가 그대로 월간 리포트의 첫 장입니다.
6. 재측정 주기: 언제 다시 재야 숫자가 움직이는가
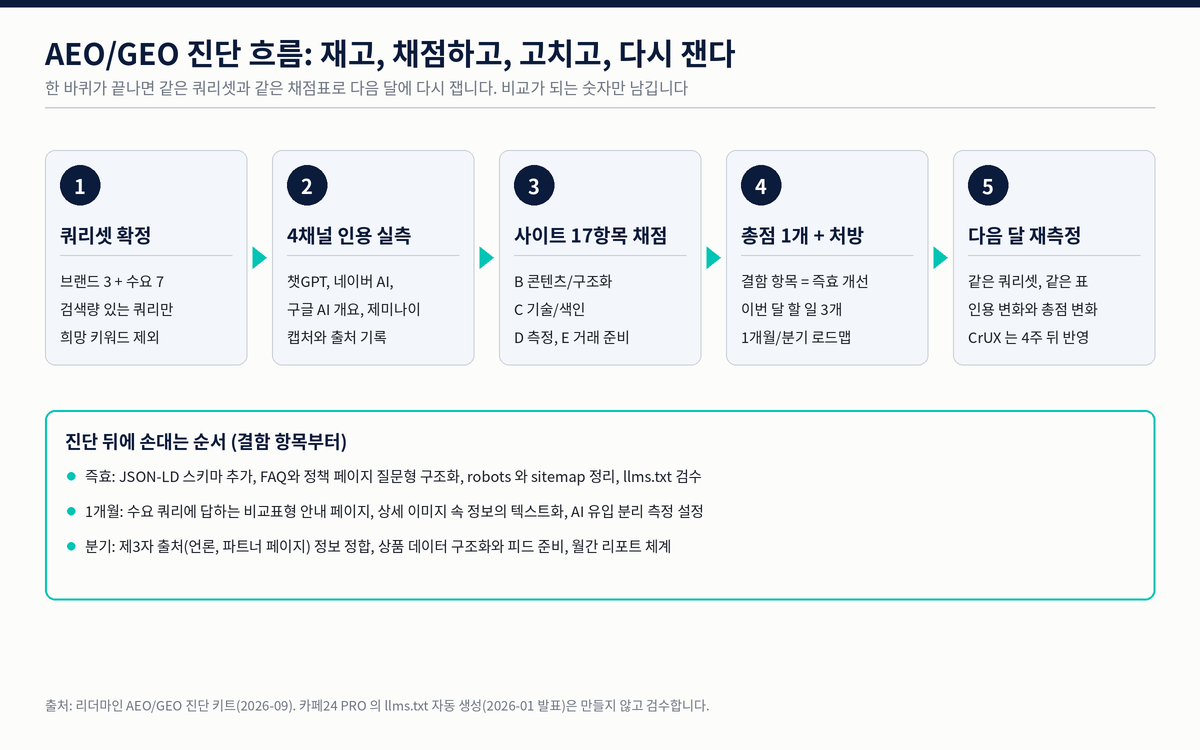
진단은 쿼리셋 확정, 4채널 인용 실측, 17항목 채점, 총점과 처방, 다음 달 재측정으로 한 바퀴 돕니다. 담당자가 직접 할 수 있는 것은 첫째와 셋째, 다섯째입니다.
주기는 월 1회입니다. 다만 같은 날 재도 움직이는 숫자와 안 움직이는 숫자가 갈립니다. 스키마와 FAQ 구조화 같은 즉효 항목은 배포 직후 회차에서 재판정됩니다. 속도 항목(C4)은 두 숫자를 구분합니다. PSI 같은 랩 수치는 고친 즉시 바뀌지만 실사용 수치(CrUX)는 28일 이동 집계라 배포 뒤 4주가 지나야 반영됩니다. 그래서 배포일을 기록해 두고 속도 재판정은 4주 뒤 회차에서 합니다.
이미지 alt 와 이미지 속 글자의 텍스트화는 아직 17항목에 없습니다. 카페24 몰은 상세 정보가 이미지 안에 있는 경우가 많아 다음 판 후보입니다.
7. 점수보다 중요한 것
이 자가 재지 못하는 것도 적어 둡니다. 17항목 점수는 "AI 가 우리 몰을 인용할 수 있는 상태인가" 를 재는 점수입니다. 환경을 갖췄다는 뜻이지 노출이 보장된다는 뜻이 아닙니다.
실제 노출을 가르는 것은 둘 더 있습니다. 첫째는 질문입니다. 브랜드 이름을 물었을 때 나오는 것은 기본이고, 브랜드를 모르는 사람이 카테고리로 물었을 때 나오는지가 진짜 시험입니다. 둘째는 반복입니다. 같은 질문에 여러 출처가 같은 사실을 말할수록, 그 페이지가 자주 언급되고 링크될수록, 사람들이 그 답을 클릭하고 이어서 물을수록 그 출처가 앞에 놓입니다. 저희 실측에서 보이는 경향이고, 채널의 내부 기준은 공개되어 있지 않습니다.
17항목 점수는 출발 조건이고, 성적표는 A 영역의 인용 실측이며, 그 사이를 채우는 것은 매달의 콘텐츠와 측정입니다.
저희 기록에서는 기준과 비교를 표로 정리한 페이지가 AI 답변에 인용되는 패턴이 확인됐고, 그래서 B2 를 독립 항목으로 뒀습니다. 한 번 구조를 갖춘 몰보다 매달 인용되는 몰이 다음 달에 더 자주 인용됩니다.
자주 묻는 질문
담당자가 직접 채점해도 되나요?
됩니다. 3절 측정 절차와 4절 판정 규칙만 있으면 B, C, D 영역은 혼자서도 잽니다. A 영역은 40칸을 채우는 손이 많이 가는데, 처음 한 회차는 직접 해 보시길 권합니다.
17항목을 전부 재지 못하면 총점은 어떻게 되나요?
못 잰 항목은 미측정으로 두고 분모에서 뺍니다. 그 영역의 배점을 실측 항목끼리 균등하게 나눠 잠정 총점을 내고, 실측 5/17 처럼 몇 항목을 쟀는지 같이 적어 확정 총점과 구분합니다.
챗GPT 에서 우리 몰이 한 번 나왔으면 된 것 아닌가요?
좋은 출발입니다. 다음은 셋입니다. 나머지 채널 세 곳에서도 나오는지, 정보가 맞는지, 출처가 우리 페이지인지입니다. 출처가 제3자면 그 정보가 틀렸을 때 바로 고칠 수 없습니다.
기존 SEO 점검표와 무엇이 다른가요?
기술 항목(C)과 측정 항목(D)은 상당 부분 겹칩니다. 다른 점은 순위가 아니라 인용을 본다는 것, 그리고 AI 가 재료로 삼는 표와 질문형 FAQ, 제3자 출처, 구조화 데이터를 독립 항목으로 둔다는 것입니다.
카페24 PRO 를 쓰면 llms.txt 가 자동으로 생기는데 진단이 필요한가요?
PRO 가입 자체가 신청이 필요한 유료 서비스입니다. 가입한 몰은 llms.txt 가 약 1주일 뒤 자동 생성됩니다. 다만 llms.txt 는 C2 한 항목의 일부이고, 그 위에 내용 검수와 나머지 16항목이 남습니다.
점수는 얼마 만에 오르나요?
항목마다 다릅니다. 스키마와 FAQ 구조화 같은 즉효 항목은 배포 직후 회차에서 판정이 바뀝니다. AI 채널 인용은 월 단위로 비교하고, 실사용 수치인 CrUX 는 배포 뒤 4주가 지나야 반영됩니다.
진단을 맡기면 무엇을 받나요?
표지에 총점 1개, 본문에 17항목 판정과 근거 캡처, 즉효 개선 목록, 다음 달 재측정 기준입니다. 1절의 리포트 1장 예시가 그 표지의 형태이고, 개선 작업은 별도 범위입니다.
우리 몰은 몇 점일까, 같은 표로 재 드립니다.
카페24 엔터프라이즈 공식 파트너 리더마인의 AEO/GEO 진단